Von der Datenstrategie über Architektur, Data Engineering und Use Cases bis in den Betrieb. Wir bauen die Plattform, die Ihr Team danach selbst weiterentwickelt.
ArchitekturZielarchitektur und Datenmodell festlegen, bevor gebaut wird.
Data EngineeringQuellen anbinden und Daten geprüft zusammenführen.
Use CasesAnalytics, Automatisierung, Apps und KI live bringen.
Betrieb und EnablementGovernance einziehen, Verantwortung übergeben.
Eine konsolidierte Plattform statt vieler Einzellösungen
In den meisten Unternehmen ist die Datenlandschaft über Jahre gewachsen. Für jede neue Anforderung kam eine weitere Datenpipeline dazu, häufig mit eigenem Werkzeug und eigener Berechnung derselben Kennzahl. Langfristig skaliert dieser Ansatz nicht. Zahlen aus mehreren Systemen müssen in Abstimmungsrunden abgeglichen werden, und oft bleibt unklar, welche Kennzahl die richtige ist. Mit jedem weiteren Use Case für Analytics, Automatisierung, Apps und KI wächst dieser Abstimmungsaufwand, und die gewachsene Datenlandschaft stößt an ihre Grenzen.
Auf einer Data- & AI-Plattform laufen die Daten aller relevanten Quellsysteme an einer Stelle zusammen und werden dort einmal bereinigt, historisiert und zu einer gemeinsamen Sicht zusammengeführt. Analytics, Automatisierung, Apps und KI greifen anschließend auf dieselbe Basis zu. Wir bauen solche Plattformen auf Azure Databricks, von der ersten Architekturskizze bis in den produktiven Betrieb.
Damit die Plattform trägt, müssen Datenarchitektur und Datenmodell zu Ihren Quellsystemen passen.
Sechs Bausteine bilden das Fundament, darauf entstehen Ihre Use Cases.
Anbindung der Quellsysteme
SAP, Microsoft Dynamics 365, Salesforce, MES- und Logistiksysteme, Dateien, APIs und weitere Quellen. Wir wählen je Quelle das passende Verfahren, von Batch über Change Data Capture bis Streaming, und legen die Rohdaten unverändert ab, damit jede spätere Auswertung gegen den Ursprung prüfbar bleibt.
Datenarchitektur und Datenmodellierung
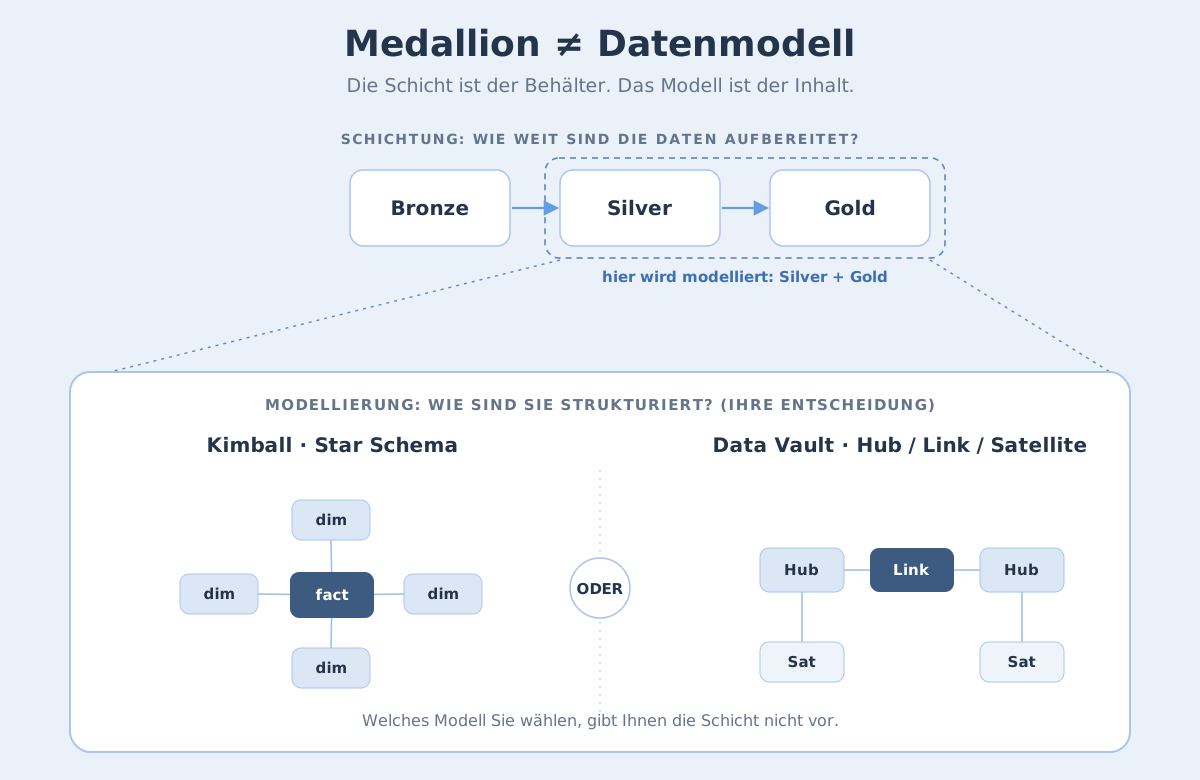
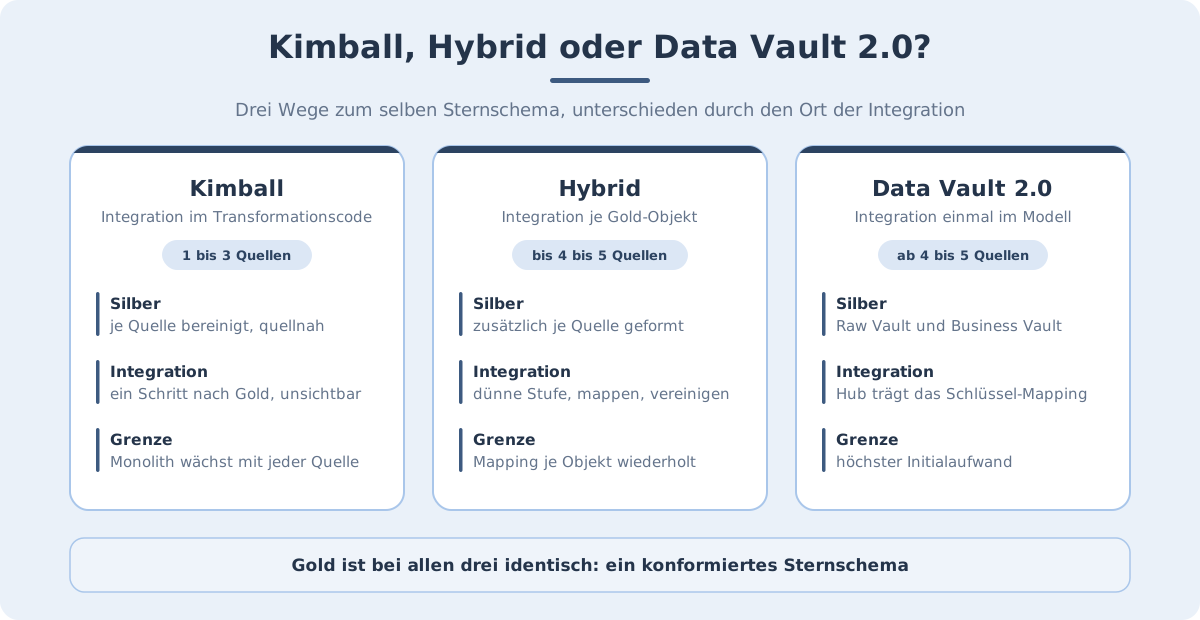
Die Architektur legt fest, wie die Daten von Bronze über Silver bis Gold aufbereitet werden und wie Kataloge, Umgebungen und Compute in Azure Databricks zugeschnitten sind. Beim Datenmodell entscheidet die Wahl zwischen Kimball, Hybrid und Data Vault 2.0, wie gut die Plattform mit neuen Quellen und Anforderungen mitwächst. Wir treffen sie anhand Ihrer Quellsysteme, Ihrer Historisierungspflichten, der späteren Nutzung und der Erfahrung in Ihrem Team und legen die Abwägung offen.
Data Engineering und Transformation
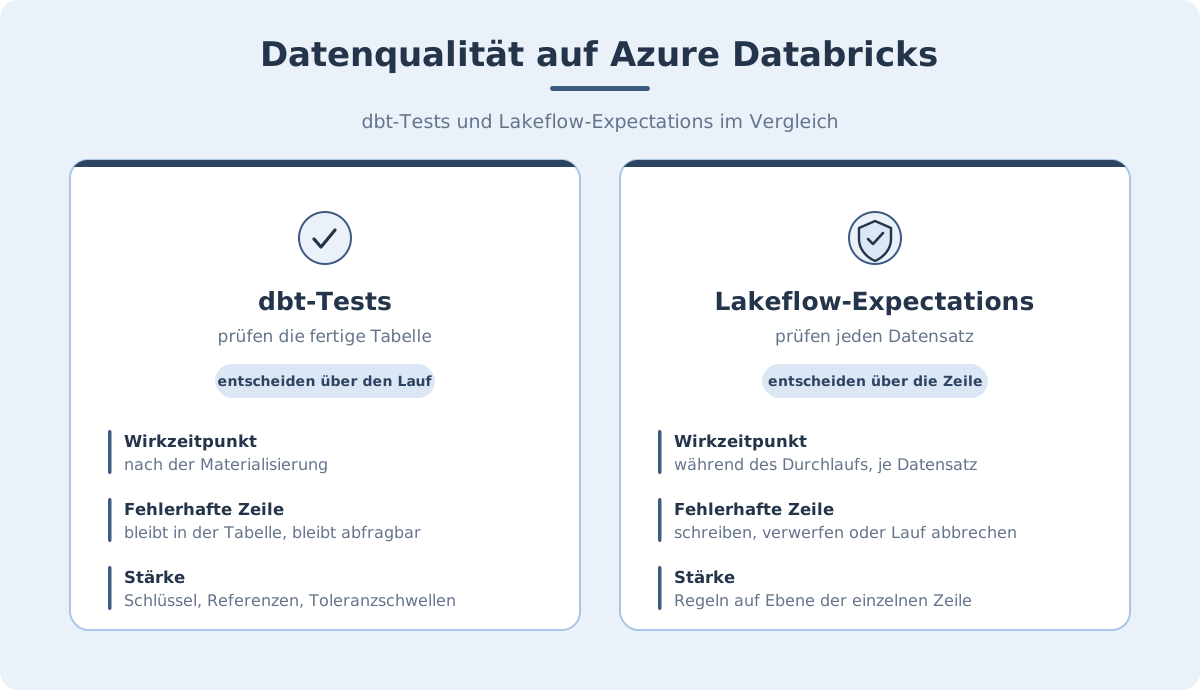
Datenpipelines mit dbt oder Lakeflow, versioniert in Git und automatisiert ausgerollt über Entwicklung, Test und Produktion, mit Tests auf Schlüssel, Beziehungen und fachliche Plausibilität. Orchestrierung, Fehlerbehandlung und Wiederanlauf sind von Anfang an Teil davon.
Governance und Betrieb
Zugriffsrechte bis auf Zeilen- und Spaltenebene und nachvollziehbare Herkunft jeder Kennzahl, auf Azure Databricks über Unity Catalog. Dazu Monitoring der Datenpipelines, Kostenkontrolle und eine abgesicherte Azure-Umgebung mit Netzwerk- und Identitätskonzept. Wie sich das bis in die Auswertung fortsetzt, steht auf Analytics & Self-Service BI.
Enablement
Ihr Team arbeitet vom ersten Sprint an mit, nicht erst bei der Übergabe. Konventionen werden dokumentiert, Entscheidungen begründet festgehalten, und die Verantwortung wandert schrittweise ins Haus.
Ablösung bestehender Lösungen
Meist bestehen bereits ein Data Warehouse, Ladeprozesse oder Berichte, die weiterlaufen müssen. Ein reiner Umzug geht schnell, übernimmt aber auch deren bekannte Schwächen. Wir nehmen die vorhandene Landschaft deshalb zuerst auf und entscheiden je Ladeprozess: unverändert übernehmen, überarbeiten oder im Zielmodell neu aufbauen. Was neu entsteht, legen wir auf kurze Laufzeiten und niedrige Betriebskosten aus. Umgestellt wird Geschäftsobjekt für Geschäftsobjekt, Alt und Neu laufen eine Zeit lang parallel und werden verglichen, bevor der alte Ladeprozess abgeschaltet wird.
Analytics, Automatisierung, Apps und KI
Auf dem Fundament laufen Berichte und Self-Service BI, Automatisierungen wiederkehrender Abläufe, Apps für Fachbereiche und KI-Anwendungen. Berichte entstehen in Power BI direkt auf den Daten in Azure Databricks, Fragen in natürlicher Sprache beantwortet Genie. Jeder neue Use Case nutzt die Daten und Regeln der bestehenden mit. Mehr dazu unter Analytics & Self-Service BI und KI-Anwendungen & Automatisierung.
Welches Datenmodell zu Ihren Quellen passt, können Sie vorab einschätzen
Der zweite Baustein oben, die Wahl zwischen Kimball, Hybrid und Data Vault 2.0, ist die Entscheidung mit der längsten Wirkung. Unser Kompass stellt Ihnen dazu 15 bis 18 Fragen und liefert in fünf bis zehn Minuten eine begründete Ersteinschätzung samt Beispielobjekten und Abwägungen.
Vier Phasen. Die erste liefert eine Entscheidungsgrundlage, ab der zweiten entsteht etwas Produktives.
12 bis 4 Wochen
Use Cases und RoadmapQuellen, Anforderungen und Nutzerkreis erheben, Use Cases priorisieren, Architektur und Reihenfolge festlegen
24 bis 8 Wochen
Erster Use Case livePlattform, Governance und die ersten Datenpipelines bis zum ersten Use Case bei den Nutzern
3je nach Umfang
Weitere Use CasesEin Fachbereich oder Use Case je Stufe, am Ende jeweils produktiv
4begleitend
ÜbergabeIhr Team arbeitet mit, Konventionen und Entscheidungen sind dokumentiert
Phase 2 ist hervorgehoben, weil dort das Fundament entsteht: Datenmodell, Governance und die erste durchgehende Datenpipeline. Jede weitere Ausbaustufe baut darauf auf, ein späterer Austausch wäre entsprechend aufwendig.
Datenstrategie als erste Phase
Die Datenstrategie legt fest, welche Use Cases zuerst kommen und welche Architektur und welches Datenmodell sie brauchen.
Datenstrategie bieten wir nicht als eigenes Vorhaben mit Abschlussbericht an. Bei uns ist sie der erste Schritt, Use Cases und Roadmap, und beantwortet die Fragen, aus denen die Zielarchitektur folgt:
Welche Entscheidungen soll die Plattform tragen, und welche Kennzahlen gehören dazu?
Welche Quellsysteme liefern die Daten dafür, und wie oft ändern sie sich?
Welche Anforderungen bestehen an Historisierung und Nachweisbarkeit?
Wer arbeitet später damit, eine Abteilung oder das ganze Unternehmen?
Welche Kompetenzen hat Ihr Team, und welche braucht es für Betrieb und Weiterentwicklung?
Am Ende dieser Phase stehen eine Zielarchitektur, eine begründete Modellierungsentscheidung, eine priorisierte Reihenfolge der Use Cases und eine realistische Aufwandseinschätzung für die erste Ausbaustufe. Auf dieser Grundlage entscheiden Sie über den nächsten Schritt.
FormatKickoff, Interviews mit Fach- und IT-Seite, technische Sichtung, Abschlussworkshop
Dauer2 bis 4 Wochen, je nach Anzahl der Quellen und der beteiligten Bereiche
ErgebnisseZielarchitektur, Modellierungsentscheidung mit Abwägung, priorisierte Use Cases, Kostenschätzung, Angebot für den ersten Use Case
Wir arbeiten mit einer Plattform und kennen sie in der Tiefe, auch die neuen Funktionen. Sie profitieren von Erfahrung aus Projekten, die bereits im Betrieb sind.
Erfahrung aus einer Hand
Sie arbeiten durchgehend mit erfahrenen Architekten, die Konzeption und Implementierung selbst verantworten. Große Projektteams und lange Abstimmungswege fallen weg.
Schneller produktiv
Aus unseren Projekten bringen wir Architektur-Blueprints, Vorlagen und Code-Pakete mit. Ihr Projekt startet nicht bei null, und Use Cases gehen damit in Wochen statt Monaten live.
Enablement statt Abhängigkeit
Wir befähigen Ihre Teams, die Plattform eigenständig weiterzuentwickeln.
Häufig gestellte Fragen zum Aufbau von Data- &AI-Plattformen
Zum Aufbau gehören sechs Bausteine für das Fundament:
Anbindung der Quellsysteme
Datenarchitektur mit dem Datenmodell
Datenverarbeitung mit Orchestrierung, Tests und automatisierten Deployments
Governance und Betrieb: Zugriffsrechte, Data Lineage, Monitoring, Kostenkontrolle und die Sicherheit der Azure-Umgebung
Enablement Ihres Teams
Ablösung bestehender Lösungen, wo bereits eine Datenlandschaft besteht
Darauf entstehen die Use Cases. Was dafür gebaut wird, hängt von der Art des Use Case ab:
Analytics: abgestimmte Kennzahlen, semantische Modelle und Berichte
Automatisierung: Workflows, die Ihre Systeme ansteuern
Apps: Anwendungen für Fachbereiche, die direkt auf der Plattform laufen
KI: Agenten und Modelle samt Bewertung und Überwachung
Am häufigsten unterschätzt werden Governance und Betrieb. Beim ersten Use Case fallen sie kaum ins Gewicht, mit mehreren Use Cases, mehr Nutzern und wachsender Komplexität entscheiden sie darüber, ob die Plattform stabil und wirtschaftlich bleibt.
Die erste Phase mit Use Cases und Roadmap dauert zwei bis vier Wochen. Danach geht der erste Use Case in der Regel nach vier bis acht Wochen in Betrieb, zusammen mit dem Fundament der Plattform aus Datenmodell, Governance und den ersten Datenpipelines. Anschließend wächst die Plattform in Stufen, je Stufe ein Fachbereich oder Use Case, der für sich produktiv geht. Am meisten Zeit kosten erfahrungsgemäß Zugänge und Abstimmungen, etwa die Netzwerkfreigaben für die Azure-Umgebung oder die Einigung auf eine Kennzahl über mehrere Bereiche. Beides klären wir deshalb schon in der ersten Phase. Wird ein bestehendes Data Warehouse abgelöst, laufen Alt und Neu zusätzlich eine Zeit lang parallel.
Die Kosten bestehen aus dem Projekt und dem laufenden Betrieb der Plattform. Im Projekt kostet die erste Phase mit Use Cases und Roadmap ab 4.750 € zzgl. MwSt. Für den ersten Use Case erhalten Sie danach ein Angebot, weitere Use Cases rechnen wir nach Aufwand ab. Die Plattform selbst rechnet Microsoft nach Verbrauch über Ihr Azure-Konto ab: Azure Databricks in Databricks Units (DBU) für die genutzte Rechenleistung, bei klassischem Compute zusätzlich die virtuellen Maschinen, dazu Speicher und Netzwerk. Die Höhe hängt vor allem von Datenmenge, Ladefrequenz und Zahl der Abfragen ab, eine Schätzung ist Teil der ersten Phase. Wir richten die Plattform so ein, dass sich ungenutzte Rechenleistung automatisch abschaltet und der Verbrauch je Use Case sichtbar ist. Bei gleichmäßiger Last senkt ein Vorabkauf von Databricks Commit Units für ein oder drei Jahre den Preis je DBU.
Beides kommt vor. Bei einem Neuaufbau lassen sich Architektur und Datenmodell am leichtesten festlegen, weil noch nichts umgebaut werden muss. Läuft bereits eine Plattform produktiv, ist ein Komplettumbau selten sinnvoll. Dann bauen wir auf dem Bestehenden auf und ersetzen einzelne Teile schrittweise, während der Betrieb weiterläuft.
Für die Ablösung kommen drei Ansätze in Frage:
Lift & Shift: Ladeprozesse, Datenmodell und Logik ziehen weitgehend unverändert auf Azure Databricks um. Das ist der schnellste Weg aus dem Altsystem, und die Ergebnisse lassen sich direkt mit dem Bestand vergleichen. Bekannte Schwächen ziehen allerdings mit, und die Möglichkeiten der neuen Plattform bleiben großteils ungenutzt.
Replatforming: Das Datenmodell bleibt im Kern erhalten, Ladeprozesse und Logik stellen wir auf Lakeflow oder dbt um. Das dauert länger als ein reiner Umzug, verkürzt aber die Laufzeiten und senkt die Betriebskosten. Schwächen im Datenmodell bleiben bestehen.
Neuaufbau im Zielmodell: Architektur und Datenmodell entstehen neu, das alte Data Warehouse dient als Referenz für den Abgleich. Das ist der aufwendigste Weg und verlangt mehr Abstimmung mit den Fachbereichen. Dafür entsteht ein Fundament, das neue Quellen und Use Cases ohne Umbau aufnimmt.
Welcher Ansatz passt, hängt vor allem davon ab, wie viel Zeit bis zum Ende von Lizenzen oder Support des Altsystems bleibt, in welchem Zustand die bestehende Logik ist und welche Use Cases die Plattform künftig tragen soll. Oft fällt die Wahl je Bereich unterschiedlich aus. Wir beraten Sie dazu auf Grundlage der Bestandsaufnahme und legen die Abwägung offen.
Unabhängig vom Ansatz lösen wir schrittweise ab, während das bestehende System weiterläuft:
Bestandsaufnahme: Wir erfassen, welche Ladeprozesse, Tabellen und Berichte es gibt und welche davon tatsächlich genutzt werden. Dazu dokumentieren wir, welche Geschäftsregeln und Kennzahlendefinitionen gelten und wo sie heute umgesetzt sind, etwa in Stored Procedures, ETL-Paketen oder Berichten.
Umfang festlegen: Nicht mehr genutzte Objekte werden in Abstimmung mit dem Fachbereich stillgelegt statt migriert. Für alle übrigen legen wir gemeinsam fest, ob sie übernommen, überarbeitet oder im Zielmodell neu aufgebaut werden.
Umstellung je Geschäftsobjekt: Ein automatischer Abgleich prüft Zeilenzahlen, Summen und Einzelwerte zwischen Alt und Neu, und der Fachbereich nimmt die Ergebnisse ab.
Umzug und Abschaltung: Erst danach ziehen Berichte und Schnittstellen um, und der alte Ladeprozess wird abgeschaltet.
Historie, die in den Quellsystemen nicht mehr vorliegt, übernehmen wir einmalig aus dem alten Data Warehouse. Vorhandene SQL-Logik lässt sich teilweise automatisch übersetzen, etwa mit Lakebridge von Databricks. Auch diese Ergebnisse laufen durch den Abgleich.
Die Datenstrategie ist bei uns die erste Phase des Aufbaus. Sie klärt, welche Fragen die Plattform beantworten, welche Probleme sie lösen und welche Entscheidungen sie stützen soll, welche Quellen dafür nötig sind, welche Anforderungen an Historisierung und Nachweisbarkeit bestehen und in welcher Reihenfolge Use Cases kommen. Daraus folgt die Zielarchitektur.
Vor allem Zugänge und die richtigen Ansprechpartner. Aus der IT brauchen wir Zugriff auf die Quellsysteme und die Azure-Umgebung, Freigaben für Netzwerk und Sicherheit und je Quellsystem eine Ansprechperson für Fragen zu Feldern und Sonderfällen. Aus den Fachbereichen brauchen wir Personen, die die Prozesse kennen und fachlich entscheiden dürfen, etwa wie eine Kennzahl berechnet wird oder wann ein Vorgang als abgeschlossen gilt. Außerdem sollte auf Ihrer Seite eine verantwortliche Person Prioritäten setzen und Entscheidungen herbeiführen. Bei personenbezogenen Daten binden wir Datenschutz und, wo nötig, den Betriebsrat früh ein. In der ersten Phase sind das einzelne Termine, während des Aufbaus ein regelmäßiger kurzer Austausch. Soll Ihr Team die Plattform später selbst weiterentwickeln, planen Sie zusätzlich Zeit für die Mitarbeit ein, denn daraus entsteht die Eigenständigkeit.
Nicht zwingend. Wir können Aufbau und Betrieb übernehmen und die Plattform später mit Dokumentation und Einarbeitung an Ihr Team übergeben. Wann und in welchem Umfang, stimmen wir mit Ihnen ab.
Unser Ziel ist der Eigenbetrieb durch Ihr Team. Deshalb gehört Enablement von Anfang an in den Plan: dokumentierte Konventionen, gemeinsames Arbeiten am realen Code statt Frontalschulung, und eine schrittweise Übergabe der Verantwortung. Danach begleiten wir auf Abruf, etwa bei der Anbindung weiterer Quellsysteme, bei Architekturfragen oder bei der nächsten Ausbaustufe.
Ja, die Bausteine sind dieselben: Anbindung, Datenmodell, Datenverarbeitung, Governance und Betrieb. Wir bauen auf Azure Databricks, weil es bei Data Engineering und KI mehr Möglichkeiten bietet. Microsoft Fabric nimmt als SaaS mehr Betrieb ab und macht die Kosten über die gebuchte Kapazität planbar. Wann Fabric die bessere Wahl sein kann, steht in unserem Vergleich „Microsoft Fabric oder Azure Databricks?“.
Zum Weiterlesen
Schichtenmodell, Datenmodell und Datenqualität einer Plattform, ausführlich erklärt in unserem Blog.
„Sanalytics hat uns bei der Modernisierung unserer Datenplattform und unseres Reportings begleitet. Zudem unterstützten sie uns bei der Evaluierung von KI-Lösungen sowie bei der Entwicklung von Prototypen. Dank ihrer Unterstützung gelang der reibungslose Übergang zu einer skalierbaren Datenplattform für Group Finance mit höherer Datenqualität, besserer Performance und verbesserter Wartbarkeit.“
Christian ReimannAbteilungsleiter Business Intelligence a. hartrodt

 Azure Databricks
 David Sanadze