

Wo könnte KI bei Ihnen Arbeit abnehmen?
In 30 Minuten sprechen wir über Ihre Abläufe und wo ein erster KI-Use-Case ansetzen kann.
Erstgespräch vereinbaren
KI-Agenten, Workflows und Apps direkt auf Ihren Daten in Azure Databricks, mit den Zugriffsrechten Ihrer Plattform. So laufen sie auch nach dem Test im Alltag.
Prototypen sind schnell gebaut. Für den Alltag brauchen sie angebundene Daten, klare Zugriffsrechte und einen verantworteten Betrieb. Auf einer Data- & AI-Plattform ist das von Anfang an vorgesehen.
Die Daten aus Ihren Quellsystemen liegen geprüft in Azure Databricks, die KI arbeitet mit demselben Stand wie Ihre Berichte.
Wir legen die Rechte einmal in Unity Catalog fest. Apps und KI arbeiten mit denselben Rechten.
Jeder Ablauf wird überwacht und protokolliert, Fehler lösen eine Meldung aus. Wer den Betrieb verantwortet, legen wir mit Ihnen fest.
Wie die Plattform darunter entsteht, steht auf Aufbau von Data- & AI-Plattformen.
KI liest Dokumente und E-Mails, ordnet sie zu und füllt Formulare vor, jeweils mit Angabe der Quelle. Ihr Team prüft und gibt frei. Welche Dokumente und Daten die KI dabei sehen darf, legen wir je Use Case fest, bei Bedarf bis auf den einzelnen Nutzer.
Viele Abläufe laufen heute über Excel, E-Mail und Kalender: Fristen nachhalten, Erinnerungen schicken, Listen zwischen Systemen abgleichen. Auf der Plattform übernimmt das ein automatisierter Ablauf, der jeden Schritt protokolliert und bei Fehlern Bescheid gibt. Ihr Team bearbeitet nur noch die Fälle, die eine Entscheidung brauchen.
Schlanke Anwendungen direkt auf Ihren Daten, zum Pflegen, Prüfen und Freigeben. Was heute in Excel-Listen neben dem System gepflegt wird, liegt dann sauber auf der Plattform, mit Historie und Governance über Unity Catalog.
Mit Ihren Fachbereichen suchen wir die Abläufe, bei denen KI und Automatisierung am meisten Arbeit abnehmen, und klären Daten, Governance und Kosten.
Zum Einstieg →Wir bauen den ersten Agenten, Workflow oder die erste App auf Ihren Daten und testen mit echten Fällen, bevor es in den Betrieb geht.
Weitere Abläufe kommen dazu und nutzen dieselben Daten, dieselbe Data Governance und dieselben Bausteine.
Alle Bausteine sind Teil von Azure Databricks und greifen auf dieselben Daten und Zugriffsrechte zu.
Was uns unterscheidet:
Wir arbeiten mit einer Plattform und kennen sie in der Tiefe, auch die neuen Funktionen. Sie profitieren von Erfahrung aus Projekten, die bereits im Betrieb sind.
Sie arbeiten durchgehend mit erfahrenen Architekten, die Konzeption und Implementierung selbst verantworten. Große Projektteams und lange Abstimmungswege fallen weg.
Aus unseren Projekten bringen wir Architektur-Blueprints, Vorlagen und Code-Pakete mit. Ihr Projekt startet nicht bei null, und Use Cases gehen damit in Wochen statt Monaten live.
Wir befähigen Ihre Teams, die Plattform eigenständig weiterzuentwickeln.
Ein KI-Agent ist eine Anwendung, die eine Aufgabe in mehreren Schritten selbst erledigt: Er liest zum Beispiel eine E-Mail, sucht die passenden Daten, schlägt eine Antwort vor und legt sie zur Freigabe vor. Anders als ein Chat wartet er nicht auf jede Frage, sondern arbeitet einen Ablauf ab. Die Entscheidung bleibt bei Ihrem Team.
Abläufe, die häufig vorkommen, nach festen Regeln laufen und heute viel manuellen Aufwand kosten: Dokumente einordnen, Daten zwischen Systemen abgleichen, Fristen überwachen, Anfragen vorsortieren. Im Workshop suchen wir die Abläufe, bei denen sich das am meisten rechnet.
Ganz verhindern lässt sich das bei keiner KI, deshalb sichern wir sie mehrfach ab. Die KI nennt zu jeder Antwort ihre Quelle. Feste Regeln prüfen jede Ausgabe, bevor sie weitergeht, etwa ob Pflichtfelder gefüllt und Beträge plausibel sind. Wo es darauf ankommt, gibt Ihr Team frei. Vor dem Start testen wir mit echten Fällen, und im Betrieb messen wir weiter, wie oft die KI richtig liegt.
Nicht, wenn die Rechte sauber gesetzt sind. Zugriffsrechte vergeben wir nach Rollen und je Use Case: Ein Agent für den Einkauf sieht nur Einkaufsdaten, und arbeitet er für einen bestimmten Nutzer, gelten zusätzlich dessen Rechte. Festgelegt werden die Rechte einmal in Unity Catalog, sie gelten für Apps und KI gleich.
Das wählen wir je Use Case. Auf Azure Databricks stehen Modelle wie GPT, Claude und Gemini direkt bereit, dazu offene Modelle wie Llama oder gpt-oss, die Sie auch selbst hosten können. Wir beraten Sie bei der Wahl und empfehlen das Modell, das für Ihren Use Case am besten passt, nach Qualität, Kosten und Ort der Datenverarbeitung.
Ja, mit offenen Modellen wie Llama, Gemma oder gpt-oss. Dafür gibt es zwei Wege:
Eigene Server lohnen sich meist erst bei hoher, gleichmäßiger Auslastung oder wenn Vorgaben verlangen, dass das Modell im eigenen Rechenzentrum läuft. Modelle wie GPT, Claude und Gemini können Sie dagegen nicht selbst hosten, auf Azure Databricks stellt Databricks sie als fertigen Dienst bereit. Wo sie Ihre Daten verarbeiten, prüfen wir je Use Case. Bei offenen Modellen gehört die Lizenz zur Prüfung: gpt-oss steht unter Apache 2.0, Llama unter einer eigenen Lizenz von Meta. Auf Ihre Daten greift die KI auf beiden Wegen über Unity Catalog zu, mit denselben Rechten wie Ihre Apps. Wir beraten Sie gern, welcher Weg zu Ihrem Use Case passt, testen ihn mit echten Fällen und rechnen die Kosten durch, bevor Sie sich festlegen.
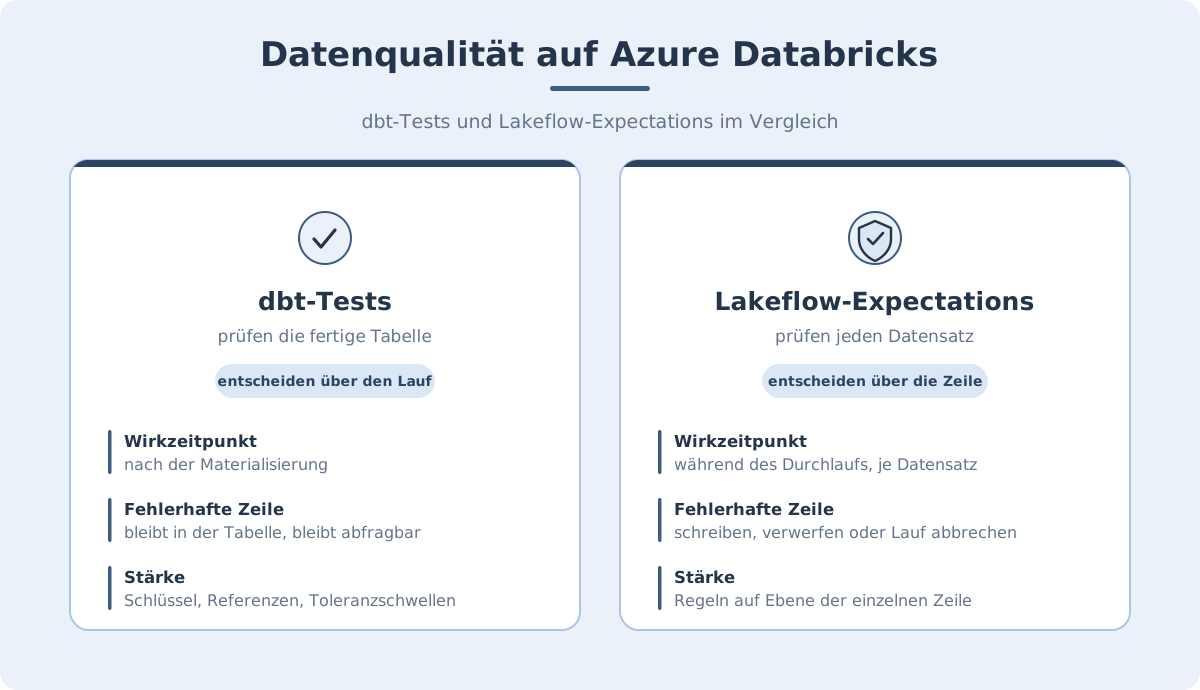
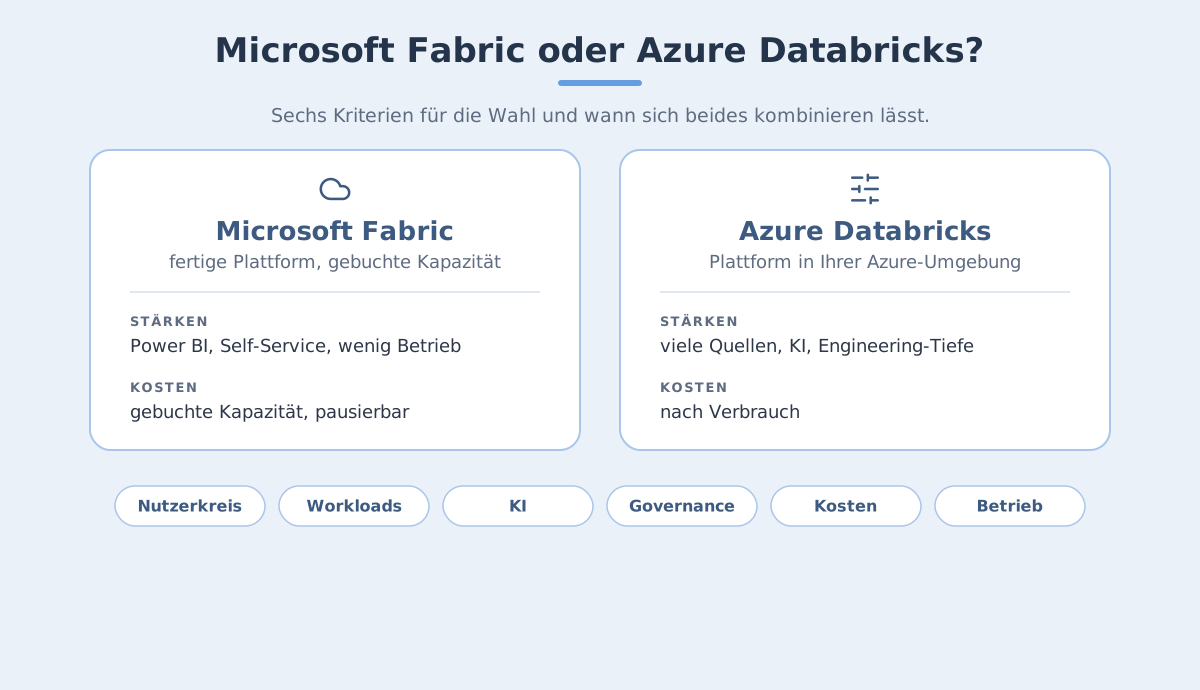
Datenqualität, Schichtenmodell und die Wahl der Plattform, ausführlich erklärt in unserem Blog.
„Sanalytics hat uns bei der Modernisierung unserer Datenplattform und unseres Reportings begleitet. Zudem unterstützten sie uns bei der Evaluierung von KI-Lösungen sowie bei der Entwicklung von Prototypen. Dank ihrer Unterstützung gelang der reibungslose Übergang zu einer skalierbaren Datenplattform für Group Finance mit höherer Datenqualität, besserer Performance und verbesserter Wartbarkeit.“


 David Sanadze
Gründer & Solutions Architect – Data & AI
In 30 Minuten sprechen wir über Ihre Abläufe und wo ein erster KI-Use-Case ansetzen kann.
Erstgespräch vereinbaren